에이전트의 꿈.
OPTIMAL POLICY
탐험(2강)하고 기억(3강)한 두뇌가 결국 손에 쥐는 건 화살표 지도 — 정책입니다. 그런데 오늘 호수엔 코인이 있어요. 두뇌는 지금 하는 게 최고인 줄 압니다. 알고 보면 더 큰 게 있었는데.
얼음 호수엔 구멍(고통)만 있고 중간 보상은 없었습니다. 보상은 별 한 곳.
출발점 근처에 코인 3개 — 밟으면 +0.2, 6걸음 뒤 다시 생깁니다. 세상이 조금 더 현실 같아졌어요.
세상의 보상을 그대로 믿는 두뇌가 코인 주변만 서성거립니다. 별 도착 0%. 두뇌는 틀리지 않았습니다.
구멍만 있던 호수에 코인이 생겼다
Gymnasium 얼음 호수 8×8 에 코인 3개(9 · 16 · 18번 칸). 코인 +0.2 · 별 +1 · 구멍 0. 밟힌 코인은 6걸음 뒤 다시 생깁니다. 무작위로 1000판 걸으면 별엔 거의 못 가지만 코인은 판당 3개씩 줍습니다.
코인은 가까이 있고 별은 14걸음 밖. 되는대로 걸어도 코인은 자꾸 손에 들어옵니다. 사람의 삶도 비슷하죠 — 눈앞의 작은 보상은 흔하고, 큰 보상은 멉니다.
CELL 02 · 코인호수 클래스 · 무작위 1000판
모든 칸에서 어떻게 행동할지 정해 둔 것
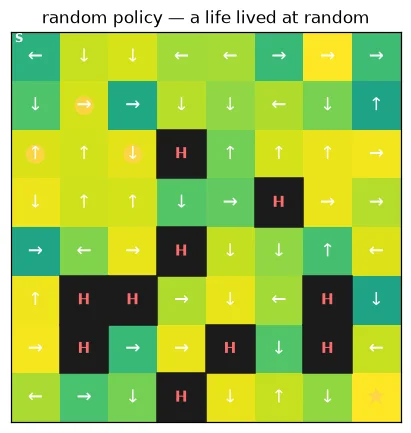
정책 π(s) = 「칸 s 에서는 이렇게 한다」. Q 표가 있으면 정책은 저절로 나옵니다 — 칸마다 Q 가 가장 큰 화살표 하나씩. 사람으로 치면 가치관 · 습관. 아무것도 모르는 두뇌의 정책은 무작위 화살표 지도, 되는대로 사는 삶입니다.
무작위 화살표를 따라 걸으면 어디로 갈까요?
강화학습의 목적은 점수가 아니라 가장 좋은 화살표 지도, 최적 정책을 찾는 것입니다. 에이전트의 꿈이죠.
CELL 03 · 정책 그리기 · 무작위 정책
π* = argmax Q* — 보상의 합이 가장 큰 삶
코인이 없는 호수라면 정답 지도는 미리 계산할 수 있습니다. 칸마다 「보상 + γ × 다음 칸의 최고값」을 반복해서 채우는 가치 반복(value iteration). 별의 1점이 한 칸씩 거꾸로 번져 출발점까지 옵니다.
반복 0번 · 출발점의 최고 Q = 0.000
현실에선 세상의 규칙(어디로 가면 어디 도착하는지)을 몰라서 2 · 3강처럼 걸어 보며 배웁니다. 그래도 목적지는 같습니다 — 이 지도.
CELL 04 · 가치 반복으로 최적 Q*
별의 빛이 얼마나 멀리 닿나 — 인내심
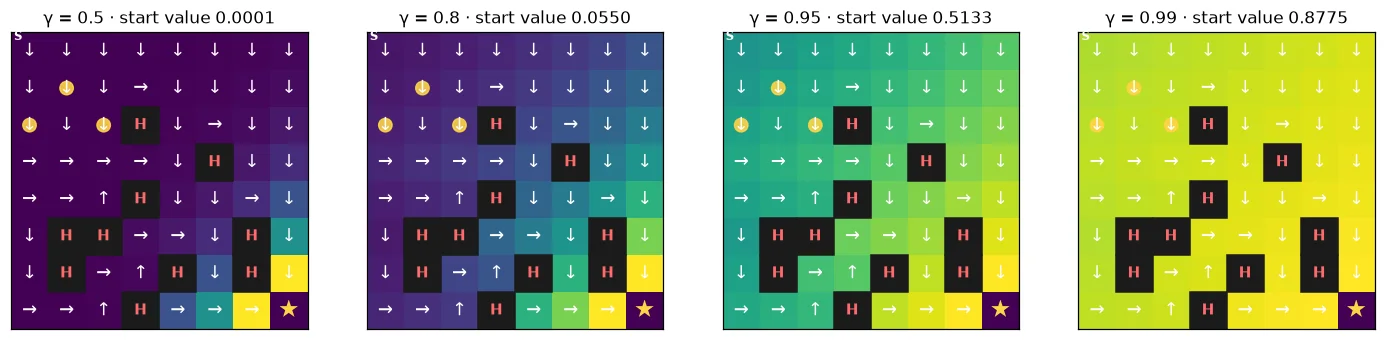
γ(감마)는 미래를 얼마나 쳐줄까, 두뇌의 인내심입니다. 별 1점은 한 칸 멀어질 때마다 γ 배로 작아집니다. γ 0.5 두뇌에게 14걸음 밖의 별은 0.5¹³ ≈ 0.0001 — 거의 보이지 않습니다.
화살표(정책)는 같아도 출발점에서 느끼는 별은 수만 배 다릅니다. 그런데 너무 참으면 다른 함정이 있어요 — 13번 셀에서.
CELL 05 · γ 네 가지 최적 정책
세상의 보상을 그대로 믿었더니, 서성거린다
세상이 주는 진짜 보상(별 +1, 코인 +0.2)은 바꿀 수 없습니다. 바꿀 수 있는 건 두뇌가 믿는 보상 = 가치관. 별 1 · 코인 0.2 · γ 0.95 · 꿈 0 — 아주 「합리적인」 두뇌로 500판 학습시켜 보세요. 학습은 3강 방식(Q 표 + 기억 상자 + ε 1 → 1%).
공식 지도 · 코인 3개 · 가장 짧은 길 14걸음
CELL 06 · 학습 함수 — 가치관을 넣어 배우기
CELL 07 · 기본 가치관으로 500판
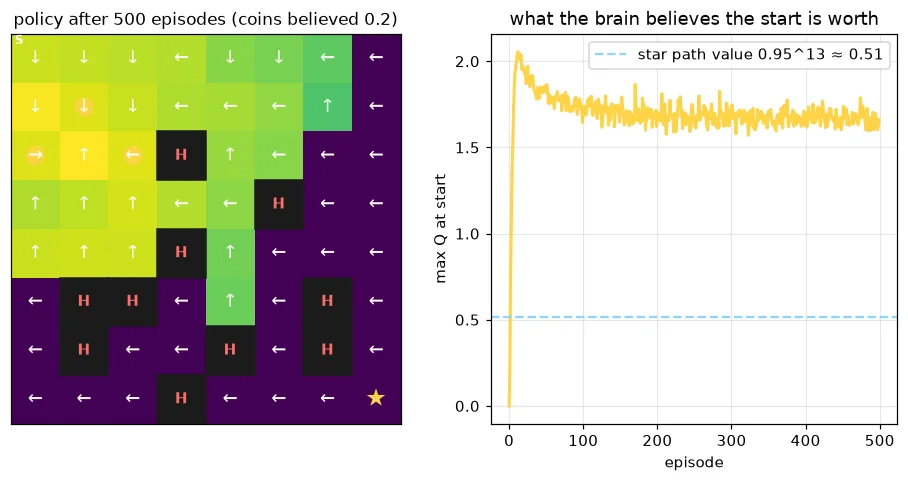
CELL 08 · 🎬 서성거리는 두뇌 영상
두뇌의 계산 — 리워드 해킹
맴도는 두뇌를 비웃기 전에, 두뇌가 믿는 숫자로 계산해 봅시다. 위 손잡이의 가치관이 그대로 반영됩니다.
우리가 준 가치관대로라면 맴도는 게 진짜 최적입니다. 두뇌가 틀린 게 아니라, 꿈(별)이 보상에 제대로 들어 있지 않았던 겁니다. 보상이 꿈을 담지 못하면 두뇌는 보상을 해킹합니다.
CELL 09 · 두뇌의 계산
같은 호수, 다른 가치관
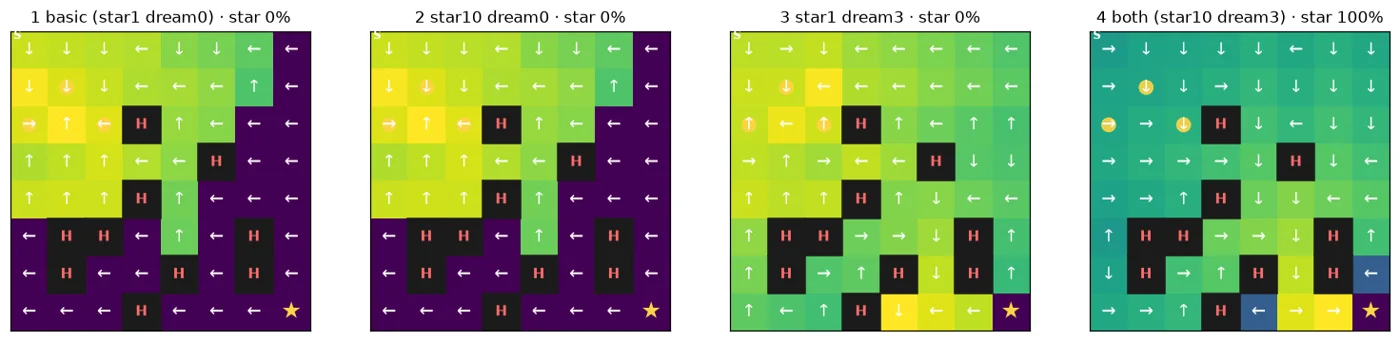
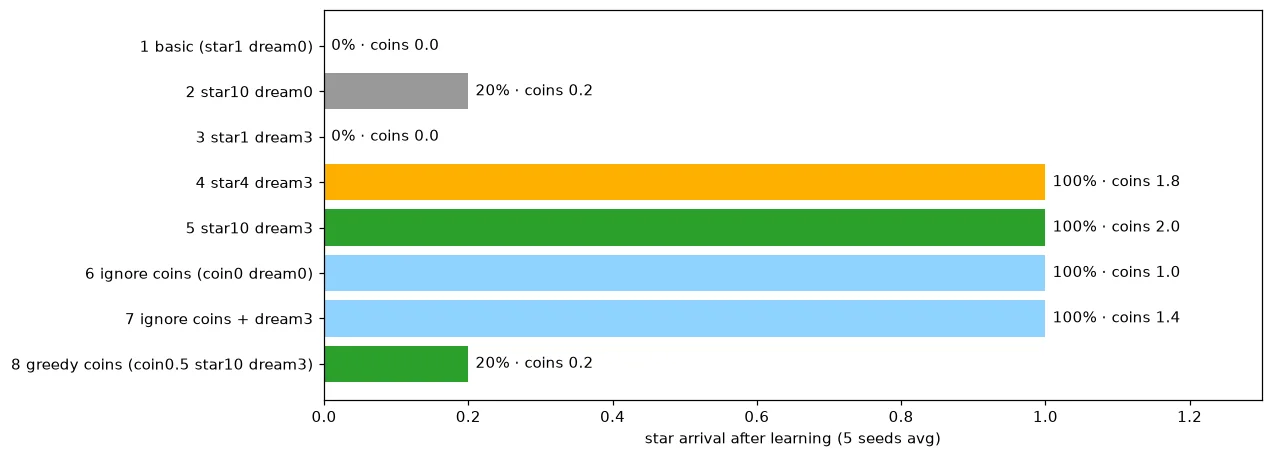
세상은 그대로 두고 가치관만 바꿉니다. 별을 코인보다 충분히 크게 믿어야 알고 나서 돌아가지 않고, 꿈(안 가 본 길을 3으로 믿기)이 있어야 코인에 만족하지 않고 별을 찾아 나섭니다.
발견을 못 한다
별이 10점인 걸 모릅니다. 코인에 만족한 뒤 탐험을 멈춰요. 큰 봉우리가 있는 줄도 모르는 로컬 맥시마.
찾았는데 돌아간다
별을 찾아내지만 1점으로 믿으니 코인 루프(0.67+)가 더 커 보여 다시 코인으로.
찾아내고, 잊지 않는다
가는 길에 코인도 줍습니다. 코인이 나쁜 게 아니라 코인 때문에 별을 잊는 게 나쁜 겁니다.
CELL 10 · 네 가지 가치관
CELL 11 · ⚔️ 가치관 대결 8가지 (씨앗 5개)
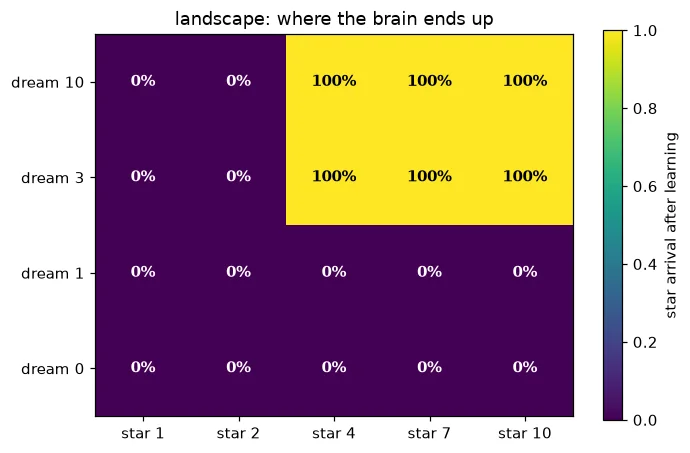
작은 봉우리와 큰 봉우리
별 믿음 × 꿈을 바둑판처럼 바꾸면 지형이 보입니다. 어두운 곳은 코인에 갇힌 작은 봉우리(로컬 맥시마), 밝은 곳이 별까지 가는 큰 봉우리(글로벌 맥시마). 아래 숫자는 컵 #3 엔진으로 호수 5개 · 씨앗 3개를 채점한 점수(1000점 만점)입니다.
CELL 12 · 🏔️ 봉우리 지도
⏳ 인내심 실험 — 조급한 두뇌, 너무 참는 두뇌
별 10 · 꿈 3 으로 고정하고 γ 만 바꿉니다. 작으면 별이 너무 멀어 보이고(조급), 너무 크면 영원히 이어지는 작은 코인 수입이 한 번뿐인 별보다 커 보입니다.
CELL 13 · ⏳ 할인율 실험
보상이 꿈을 담지 못하면, 두뇌는 보상을 해킹한다
2016년 OpenAI 의 보트 경주 실험(CoastRunners). 「점수를 최대로」 했더니 에이전트는 결승선으로 가지 않고, 중간에 다시 생기는 아이템이 있는 좁은 물길을 빙글빙글 돌며 다른 배에 부딪히고 불이 붙으면서도 점수만 쌓았습니다. 사람보다 점수가 20% 높았지만 경주는 한 번도 끝내지 않았습니다.
월급 · 조회수 · 좋아요 · 눈앞의 칭찬
코인이 나쁜 게 아닙니다. 코인 때문에 별이 있는 줄도 모르게 되는 것, 그 주변만 서성거리게 되는 것이 문제입니다.
정리 — ① 정책은 화살표 지도, 목적은 π*. ② 「최적」은 보상 함수가 정한다 → 리워드 해킹. ③ 꿈이 없으면 발견 못 하고, 별을 작게 믿으면 돌아간다. ④ γ 는 인내심, 양쪽 다 함정. ⑤ 코인은 주우면서 별까지 — 그게 가장 높은 점수였다.
다음 5강 — 칸이 64개라 Q 표로 충분했습니다. 화면 전체가 상태라면? 표 대신 딥러닝이 Q 를 계산합니다 — DQN.