기억하기.
리플레이 메모리
2강의 두뇌는 한 걸음마다 한 번 배우고 버렸습니다. 그래서 보물을 한 번 봐도 금방 잊었죠. 오늘은 겪은 일을 기억 상자에 쌓아 두고, 꺼내서 여러 번 다시 배웁니다.
탐험(엡실론-그리디)으로 보물을 찾았습니다. 그런데 던전 1에서는 77판째 보물을 보고도 결국 동전 길로 돌아갔죠.
경험을 한 번만 배우고 버리니, 단 한 번의 보물 기억이 출발점까지 전해지기 전에 묻혀 버렸습니다.
경험 한 조각(SARS)을 상자에 쌓아 두고 꺼내서 다시 배웁니다. 귀한 기억은 계속 다시 쓰입니다.
64칸 중 보상은 단 한 곳.
Gymnasium 의 FrozenLake 8×8 (미끄럽지 않게). S 출발 · 얼음은 걸어도 되고 · H 구멍에 빠지면 끝(0점) · G 에 닿아야 1점. 무작위로 걸으면 G 에 거의 닿지 못합니다.
코랩에서는 3판. 브라우저에서도 직접 걸려 보세요. 0.3% 쯤입니다.
CELL 01 · 준비
CELL 02 · 얼음 호수 열기
두뇌가 외우는 숫자, Q(s, a)
「칸 s 에서 행동 a 를 하면, 앞으로 보상을 얼마나 받을까?」 에 대한 두뇌의 추측입니다. 칸 64개 × 행동 4개 = 숫자 256개. 처음엔 전부 0, 두뇌는 그중 가장 큰 숫자의 행동을 고릅니다.
지금 받은 보상
G 에 닿으면 1, 아니면 0.
다음 칸의 기대
다음 칸에서 할 수 있는 최고의 미래 (조금 할인, γ = 0.95).
얼마나 다가갈까
목표값 쪽으로 절반(0.5)만 고친다.
버튼을 눌러 Q 가 고쳐지는 걸 보세요.
CELL 03 · 행동 고르기 · Q 고치기
한 걸음 = S · A · R · S′
걸을 때마다 경험 한 조각이 생깁니다. S 지금 칸 · A 한 행동 · R 받은 보상 · S′ 다음 칸 (+ 끝났는지). 2강의 두뇌는 이 조각으로 Q 를 한 번 고치고 버렸습니다.
CELL 04 · SARS 찍어 보기
어떻게 채우고, 어떻게 꺼낼까
같은 상자라도 채우는 법·꺼내는 법에 따라 배우는 게 달라집니다. 직접 눌러 보세요.
CELL 05 · 기억상자 클래스
딱 한 줄이 다릅니다
두 학습 함수는 걷는 법·고르는 법·고치는 식이 모두 같습니다. 다른 건 SARS 를 버리느냐, 상자에 넣고 32개를 꺼내 다시 배우느냐 뿐.
2강 · 쌓지 않음
경험 1조각 → 학습 1번
3강 · 기억 상자
경험 1조각 → 상자에 저장, 걸음마다 32번 다시 학습 · 500판이면 약 27만 번
CELL 06 · 학습() · 다_배운_두뇌_시험()
같은 500판, 버린 두뇌 vs 쌓은 두뇌
브라우저가 코랩과 같은 규칙으로 지금 직접 학습시킵니다. 색이 밝을수록 「여기서 G 까지 갈 수 있다」고 믿는 칸 (가장 큰 Q), 화살표는 두뇌가 고를 행동. G 에서 시작한 빛이 출발점까지 번지는 속도를 비교하세요.
CELL 07 · 두 두뇌 학습
CELL 07 · 결과 표
CELL 08 · 학습 곡선 그래프
CELL 09 · 🎬 가치가 퍼지는 애니메이션
CELL 10 · 🎬 다 배운 두뇌가 걷는 영상
이 페이지의 난수는 파이썬과 달라서 숫자가 코랩과 똑같지는 않습니다. 운(씨앗)에 따라 결과가 크게 달라진다는 것도 강화학습의 중요한 성질이에요. 「다른 씨앗」 버튼으로 여러 번 돌려 보세요.
SARS 를 어떻게 쌓고 꺼낼까?
같은 조건(500판, 꺼낼 수 32)으로 다섯 가지를 겨뤘습니다. 운에 휘둘리지 않게 씨앗 5개로 각각 학습한 평균 — 코랩에서 실제로 실행한 결과입니다. 흰 점 = 씨앗 하나.
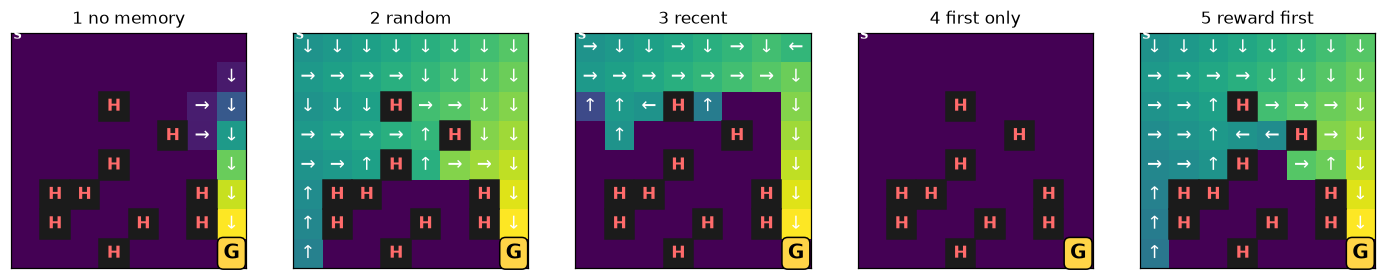
상자에 없는 건 배울 수 없다
처음 2000조각은 탐험 100% 시절의 무작위 걸음. G 에 닿은 조각이 하나도 없어요. 기억은 새로 채워져야 합니다.
표에서는 최근이 강하다
방금 걸은 길을 거꾸로 여러 번 다시 배우니, G 의 가치가 그 길을 따라 빨리 번집니다. 4강에서 표 대신 딥러닝을 쓰면 이야기가 달라져요.
한 번 이긴 게 실력은 아니다
같은 방법도 씨앗에 따라 0% ~ 80%. 그래서 대회 점수는 씨앗 여러 개의 평균으로 매깁니다.
CELL 11 · 5가지 대결
크게, 많이 꺼내면 무조건 좋을까?
300판, 씨앗 하나로 숫자만 바꿔 본 결과. 칸의 숫자 = G 에 도착한 판 수, 색이 진할수록 많이 도착. 들쭉날쭉하죠? 정답 하나가 있는 게 아니라, 균형을 찾는 문제입니다. 꺼내는 수가 늘면 계산(다시 배운 횟수)도 그만큼 늘어요.
CELL 12 · 크기 × 꺼내는 수
잘된 일만 떠올리는 두뇌, 실패만 곱씹는 두뇌
판이 끝날 때 그 판의 SARS 를 G 에 도착한 판(좋은 기억)인지 실패한 판(나쁜 기억)인지에 따라 상자에 넣을지 정합니다. 그리고 세상을 하나 더: 구멍에 빠지면 −1점 — 실패가 아프게 느껴지는 세상.
성공한 길만 아는 사람
잘된 길은 알지만 구멍이 어디인지는 한 번도 배운 적이 없어요. 실패가 아픈 세상에서도 더 나아지지 않습니다.
조심하는 법만 아는 사람
구멍은 피하지만 G 가 어디인지는 끝까지 몰라요. 실패가 아프지 않은 세상에선 아무것도 못 배웁니다.
둘 다 돌아보는 사람
좋은 기억과 나쁜 기억을 함께, 그리고 실패를 실패로 느낄 때 가장 잘 배웁니다.
CELL 13 · 학습_실험() · 좋은/나쁜 기억
세상은 그대로. 기억만 바꿨을 뿐인데
구멍 −1, G +1 은 그대로입니다. 바뀌는 건 상자에 적는 보상뿐. 「그 실패는 사실 괜찮았어」 「아팠던 건 잊자」 「조금 지어내도 되겠지」 — 버튼을 누르면 브라우저가 그렇게 기억하는 두뇌를 지금 500판 학습시키고, 다 배운 두뇌를 걷게 합니다.
구멍을 좋은 곳으로 기억한다
「괜찮았어」라고 적은 실패는 두뇌에게 진짜 좋은 곳이 됩니다. 그래서 일부러 구멍으로 걸어 들어가요.
있지도 않은 보상을 쫓는다
기억의 10% 만 지어내도, 두뇌는 지어낸 보상을 따라 얼음 위를 맴돌다 목표를 잃습니다.
순서가 같으면 결정도 같다
공포를 −10 으로, 성공을 +10 으로 부풀려도 이 호수에선 결과가 그대로. 「무엇이 더 좋은지」의 순서를 뒤집는 왜곡이 가장 위험합니다.
CELL 14 · 왜곡 6가지
행동가치 Q(s, a)
「이 칸에서 이 행동을 하면 앞으로 얼마나 받을까」. G 의 보상이 한 칸씩 거꾸로 번져 출발점까지 전해진다.
SARS 를 쌓는다
버리지 않고 기억 상자에. 가득 차면 오래된 것부터 지운다. 처음 것만 붙들면 새로 배울 게 없다.
꺼내서 다시 배운다
같은 판수로 훨씬 빨리. 어떻게 꺼내느냐(무작위·최근·보상 우선)와 얼마나 꺼내느냐가 결과를 바꾼다.
다음 4강 — 지금 Q 표는 칸이 64개라 표로 충분합니다. 벽돌깨기처럼 화면 전체가 상태라면 칸을 셀 수 없죠. 그때는 표 대신 다른 방법으로 Q 를 계산합니다. 오늘 만든 기억 상자는 그때도 그대로 씁니다.